三角钢琴琴键与黑色琴身倒影的近景

作曲,是起点。

韦兆志

正在走向 AI 训练师

从作曲,
走向 AI 训练。

广西艺术学院
作曲与作曲技术理论

探索我的学习
继续了解

我的起点

广西 · 防城港

从听见细节到理解意图

作曲让我习惯反复倾听、打磨细节。现在,我正在系统学习 AI 训练师课程,理解数据、规则与模型回答之间的关系。

广西艺术学院 · 作曲与作曲技术理论
广西防城港 · AI 训练师方向

01 / 项目流程

流程,先想完整。

从一个需求,到一份合格的数据。
课程学习整理 · 09.19

第一步 · 需求与规则

把模糊的想法,
变成共同标准。

先确认目标、数据内容与验收要求,再用正例、反例和边界情况,把规则说明白。

先问清楚,再开始。

这一阶段,形成什么

需求 / 规则文档

业务目标
为谁服务,提升什么能力
数据范围
类型、内容、格式与量级
判断标准
正反例、边界与验收要求

第二步 · 培训与试标

先跑通一小步,
再让团队走一致。

自己先试标,匹配执行人员,再进行培训与小批量验证。发现歧义,就回到规则里解决。

试标,同时检验人员与规则。

这一阶段,形成什么

试标 / 问题记录

亲自试标
验证规则,记录用时
培训对齐
讲背景、规则与边界案例
小批量验证
检查准确率,分析理解分歧

第三步 · 生产与质检

推进每一批数据,
也看清每一个问题。

安排任务与质检职责,跟踪进度和质量。把问题样本分类,区分规则、人员或数据本身的原因。

把共性问题,写回规则。

这一阶段,形成什么

生产 / 质检记录

任务安排
人员、职责与交付节点
质量检查
标注、复核与内部验收
问题归因
记录错误类型,跟进修正

第四步 · 交付与验收

交付有依据,
反馈有着落。

汇总数据、分批交付,对照约定标准验收。出现分歧时,逐条评审,完成返修后再次验证。

标得准确,也要交得可用。

这一阶段,形成什么

交付 / 验收清单

汇总核对
字段完整,格式与版本一致
业务验收
按已确认的规则逐项检查
反馈闭环
评审、返修与再次验收

第五步 · 复盘与改进

让这一次的经验,
成为下一次的方法。

回顾准确率、效率与成本,找出反复出现的问题,把有效做法整理成可复用的标准流程。

交付之后,学习继续。

这一阶段,形成什么

复盘 / 标准流程

质量复盘
错误分布与返工原因
效率与成本
时间用在哪里,如何改进
经验沉淀
案例库、常见问题与 SOP

02 / 模型训练

好回答有迹可循

从基础学习,到高质量示范,
再到更符合需求的选择。

预训练建立基础能力
SFT监督微调用高质量示范,学习如何回答。
RM + PPO

学习评价,依据奖励优化。

DPO

通过偏好回答对,直接优化。

我关注示范质量、偏好判断与规则一致性。

03 / 推理与 Agent

先想清楚再行动

CoT 关注推理的质量。
Agent 将理解,落实为下一步。

  1. 01理解

    识别目标与信息缺口

  2. 02规划

    拆分任务,判断下一步

  3. 03调用

    选对工具,核对参数

  4. 04验证

    根据执行结果调整

不只检查最终答案,也检查过程是否有依据。

04 / 图像与视频

看清画面说清变化

图片里有主体、关系与细节。
视频里,还有时间。

图片数据

画面
  • 主体
  • 关系
  • 光影
  • 细节
筛选 · 分类 · 标签 · Caption

视频数据

时间
  • 动作
  • 镜头
  • 连续性
  • 顺序
切片 · 描述变化 · 质检 · 交付

描述充分,也保持准确。只写画面里确实存在的内容。

以上为课程学习整理。目前尚无实际项目,后续会在这里更新练习和项目。

屏幕之外

屏幕之外,
也有大收获。

音乐、Citywalk,还有钓鱼。
我喜欢专注其中,也享受偶尔的惊喜。

刚认识时有些慢热,熟悉之后,会聊得更多。
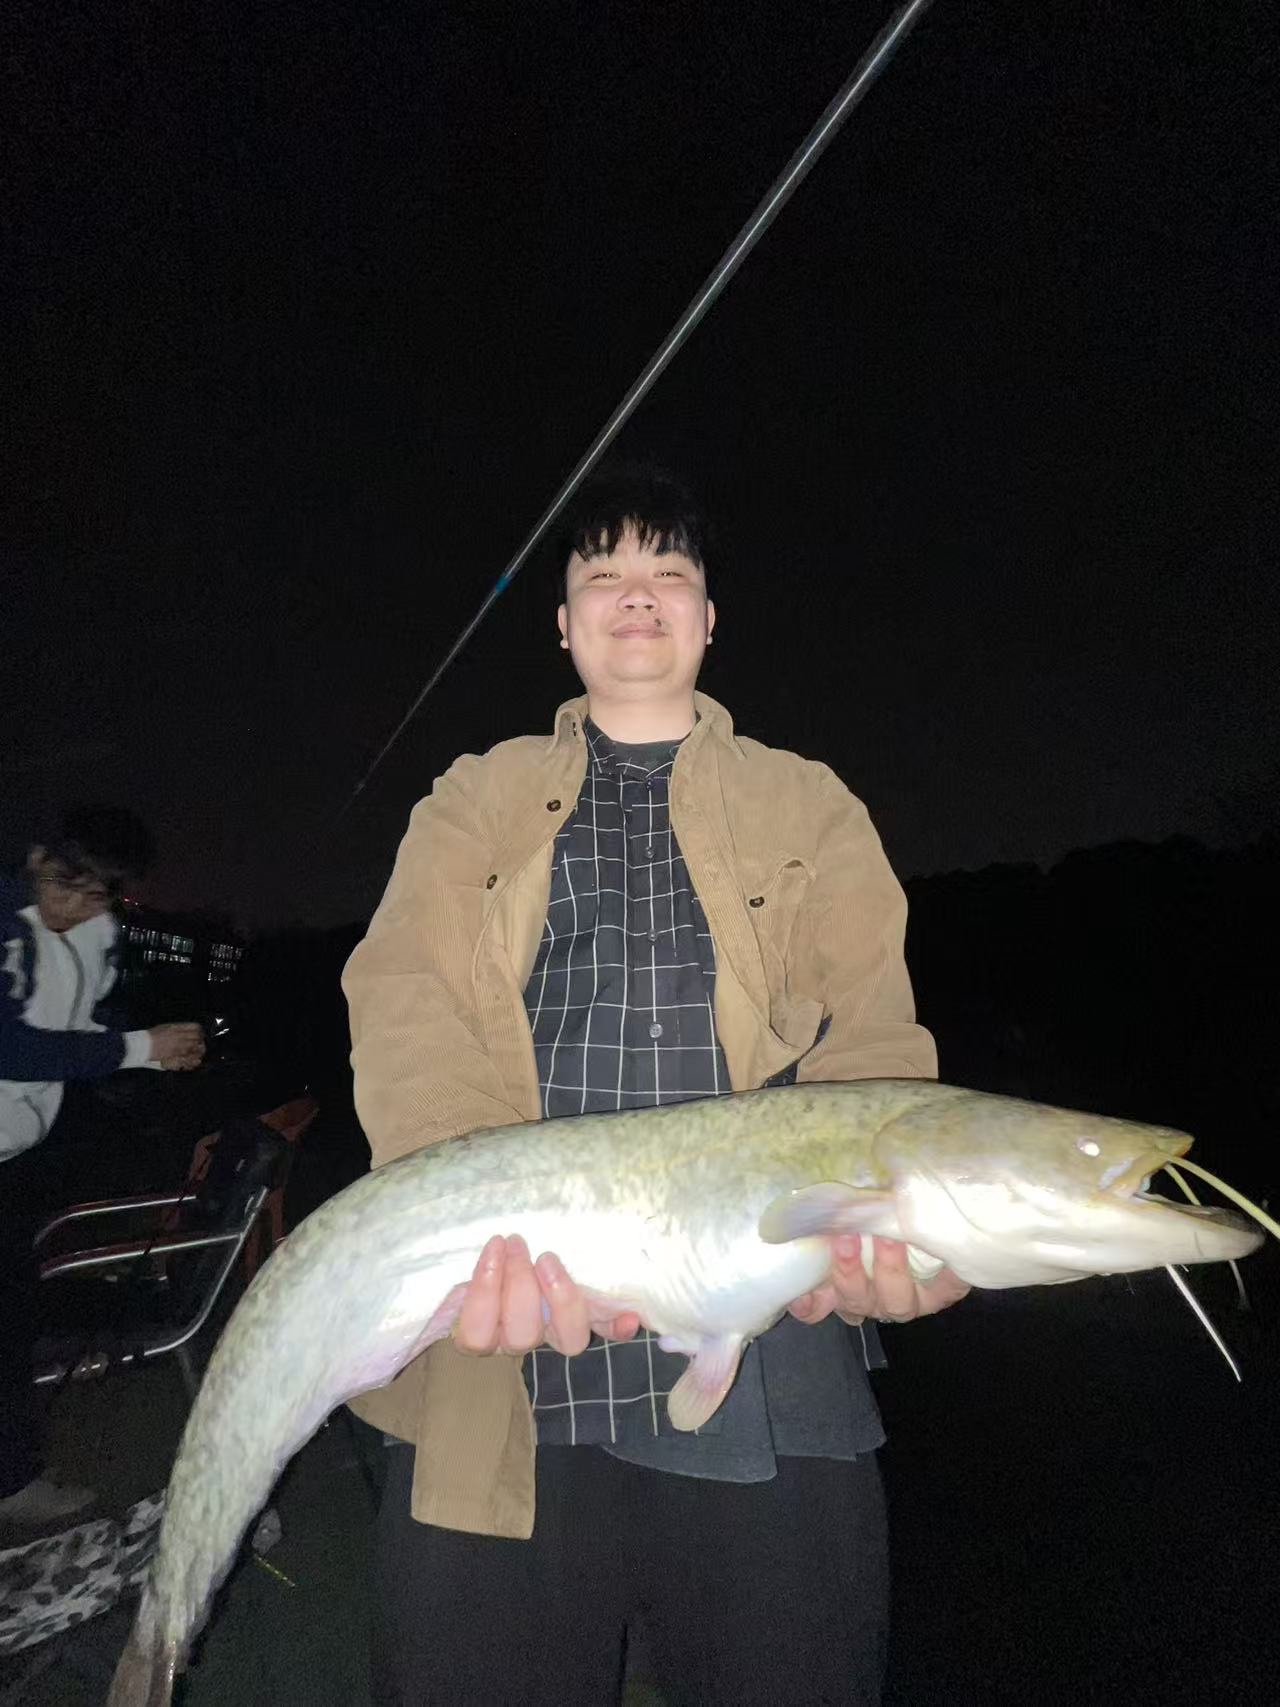
音乐钓鱼Citywalk
韦兆志夜晚钓到大鱼,双手托鱼留影;完整展示人物和鱼身
属于生活的一次大收获。

韦兆志 · AI 训练师方向

聊聊下一步

正在寻找 AI 训练师方向的工作机会。
如果你愿意进一步聊聊,欢迎联系。

150 0770 5249
02 / 模型训练 · 学习整理

从数据到模型能力

理解每一步,
在学习什么。

训练方法各有目标,也需要不同形式的数据。下面是我目前学习到的基本关系。

预训练学习基础规律SFT学习高质量示范

偏好优化的两条常见路线

RM + PPO学习评分,再依据奖励优化
DPO利用优选 / 非优选回答对直接优化
预训练
从大量数据中学习语言规律与知识,为后续任务提供基础能力。
SFT 监督微调
提供高质量的指令与回答示例,让模型学习怎样按要求完成任务。
RM 奖励模型
通过回答比较与偏好数据,学习什么样的输出更符合评价标准。
PPO 近端策略优化
一种强化学习优化算法,可以利用奖励信号调整模型的输出策略。
DPO 直接偏好优化
用同一问题下的优选与非优选回答对直接优化模型,无需另行训练显式奖励模型再运行 PPO。
我关注的数据工作

优质示范、偏好判断、规则一致性与数据质检。模型训练的实现与参数优化,由相应的算法团队负责。

整理自 9 月 26 日课程。以上是常见方法关系,具体训练方案依项目而定。

03 / 推理与 Agent · 学习整理

从理解任务,到完成任务

想得合理,
也要做得准确。

CoT 关注分步推理的质量;Agent 进一步结合规划、记忆与工具,将目标落实为行动。

CoT

检查推理质量

  • 是否正确理解问题
  • 步骤是否完整、逻辑是否合理
  • 推理与最终答案是否一致
  • 反思是否有效,是否存在重复空转
Agent

检查规划与工具调用

  • 任务拆解与下一步是否合理
  • 工具选择是否符合场景规则
  • 参数是否有依据、格式是否正确
  • 能否根据工具结果继续或修正

一个课堂案例

预订会议室,缺少会议时长。

用户提供了开会日期,但没有说明持续多久。这个信息会影响预订,应先询问时长,再继续检查空闲时间并预订。

识别信息缺口询问并确认继续执行
我关注的数据工作

在完整上下文中评估与修正示例,核对需求、规划、工具参数和执行结果之间的关系。

整理自 9 月 27 日课程。课堂案例用于说明判断方法。

04 / 图像与视频 · 学习整理

从素材筛选,到准确描述

看见细节,
也看见变化。

标签提供结构化信息,Caption 用自然语言描述画面。两者都要忠于实际可见内容。

先把图选对,再把图说清楚。

  1. 筛选素材按照项目规则检查清晰度、相关性与其他质量要求。
  2. 分类与标签整理主体、场景、构图、光影等结构化信息。
  3. 编写 Caption准确描述主体、动作、关系和画面细节,避免添加看不见的信息。
  4. 复核与评测检查图文是否一致,根据生成效果反馈数据问题。
我关注的数据工作

描述充分,也保持准确。图片看内容和关系,视频还要看动作、镜头与时序。

整理自 9 月 27 日课程。筛选条件、标签与切片要求随项目调整。

琴键摄影:ProtoplasmaKid · CC BY-SA 3.0 · 页面作裁切与明暗呈现